blog
•
2026年10月6日
•
18 次阅读
大模型能“连续思考”吗——从一个“思考帧”推到 Realtime API
ai
llm
agent
realtime api
今晚看了一期 Kurzgesagt 讲 AI 自主行为的视频,看完脑子就停不下来了。
冒出来的第一个问题是:**现代大模型能“连续思考”吗?**
如果不能,那在没有 agent 框架的时候,每次向大模型发送请求就产生一次输出——这个东西能不能叫**一“帧”思考**?
顺着这个问题往下推,一路推到了「实时陪伴型 agent 是怎么做的」,最后落在一句我自己觉得挺重要的话上。趁热记在这儿。
## 一、我一开始把“帧”想粗了
我本来以为:一次请求 = 一帧。
推下去发现,真正的“帧”要细得多:**一次前向传播 = 一个 token**。我让它回一段 500 字,那不是 1 帧,是 500 帧。只是“帧率”飘忽(几十到几百帧每秒),而“一次请求”只是**人类看得见的回合边界**,不是计算边界。
## 二、连续性不在模型里,在模型外面
这是今晚第一个让我坐直的点。
- 推理的时候权重**不改**。帧和帧之间**没有内部状态传递**——它不像 RNN 那样有个 h_t 带到下一刻。
- 唯一把帧串起来的是 **KV cache / 上下文**:每写一个字,下一帧都要把前面写过的所有字重读一遍。
- 所以准确的说法是:
```text
模型 = 一个无状态函数 f(纸带) -> 下一个 token
“思考” = 反复调用这个函数,并把输出写回纸带
```
跟图灵机一个结构——**模型是固定的转移函数,上下文是纸带**。
所以“连续思考”这件事,那个“连续”是**外挂的**。
## 三、两个很硬的推论
**1. 每帧的算力是固定的**
不管题多难,一次前向就是那么多层。想“想久一点”只能**多写几帧**——这就是 CoT 和 test-time compute 的本质:**用 token 换深度**。reasoning 模型就是舍得烧帧。
**2. 每帧吐出来的东西很窄**
一帧只吐**离散的一个词**,几个 bit。等于把高维的内部状态硬挤进一条低带宽通道。所以现在有“连续思维”那类研究(比如 Coconut,让模型在隐向量里直接推,不要每个字都过 token)。说白了就是:**现在做的,是把一条连续的隐轨迹抽样成离散帧。**
## 四、那实时陪伴型 agent 是怎么活的
拿 N.E.K.O.(一个开源 AI 伴侣项目)当样本扒了一遍。它的做法总结起来就一句:**把“模型做不到的连续”,全用系统层补上。**
- **实时性**:核心对话走 Realtime API,语音进语音出,而不是三段接力;
- **状态**:常驻进程 + 持久化,人格、记忆、当前活动状态都在进程外面存着;
- **记忆**:五维分层(工作 / 近期 / 事实 / 反思 / 人格),本质是**离线把经历蒸馏进人格**;
- **主动性**:主动话题模块 + 状态跟踪——**心跳和定时器就是它的自主性**;
- **手脚**:Agent 层(CUA、浏览器自动化)挂在陪伴层下面。
## 五、Realtime API 到底改了什么
扒到这一层就绕不开:厂商的 realtime API 是怎么做的?大致三步——
**1. 换协议**
从 HTTP 请求变成常开的双向流(WebSocket / WebRTC),双方互相推事件。连接一直挂着——**“帧”不再由你的请求驱动,而是由音频流驱动。**
**2. 服务端 VAD + 自动回合 + 打断**
服务端自己判断“他开始说了 / 他说完了”,说完自动触发一次回复;你插话时它能把自己正在说的话当场掐掉(barge-in)。
**3. 真·语音到语音**
不是 ASR → LLM → TTS 三段接力,而是一个 omni 模型,**音频 token 进、音频 token 出**,中间不过文字。
第 3 步同时解决两件事:
- **延迟**:三段接力每段都得收尾才能进下一段,一体化之后首包能压到几百毫秒;
- **信息量**:文字是低带宽瓶颈,而语音自带韵律、语气、情绪,**通道宽得多**。
## 六、但它一个洞都没堵
我一开始以为 realtime API 就是“输出很快的 API”。想岔了。
- 它**快的是首包和往返**,不是吞吐(omni 模型的 token/s 往往还不如大文本模型);
- **session 一断,状态清零**。它依然是无状态的 LLM,只是把帧率提上来了——记忆还得外面存(这就是 N.E.K.O. 为什么非要单起一个 memory_server);
- **它不会自己醒**。你不往里塞音频,它就不存在。主动性还是得靠外面的定时器。
所以更准确的说法是:
> **Realtime API = 把 agent 框架的一部分(VAD 触发、会话状态、双向流)内置进了模型服务。**
普通 API 是**裸的算力接口**;Realtime 是**预装了一半 agent 循环的算力接口**。
但它**替代不了 agent 框架**——没有工具循环、没有长期记忆、没有主动性。真实系统永远是两层拼:**Realtime 管嘴和耳朵,agent 框架管脑和记忆。**
## 七、那换成多模态普通 API 行不行
我最后的推论是:既然用多模态模型,“听得出情绪”这点就补上了,那普通 API 相比 realtime 的劣势是不是只剩“上下文反复搬运”?
答案是:**不是“唯一”,但确实是同一类问题里最硬的那条。**
**搬不掉的两条:**
- **上行不能流式**:普通 API 的请求是**原子的**——必须等一句话说完,再编码、打包、上传,服务端才开始算。所以最小延迟里天然有“说完 + 上传”这块地板。realtime 是边采边推,你说到一半它已经在算了。
- **双工做不了**:一次请求只有一个方向。它说话的时候,你没法同时塞一句“嗯”“对”、一声笑进去。真要模拟只能靠投机请求,成本直接翻倍。
**而“上下文重传”比听起来更贵:**
- 音频 token 本来就贵,每轮全量重传,**成本随轮数近似平方增长**;
- 缓解办法只有一个:把老音频降级成文字摘要——**可这就把“听觉记忆”又丢了一部分**,绕回起点。
另外两块也是工程活:**打断原语**(普通 API 只能 abort HTTP,服务端已经算掉、计费掉的不退)、**声学前端**(WebRTC 那条路自带抖动缓冲和回音消除,HTTP 路径全要自己扛)。
所以准确说:不是“唯一劣势”,是**“无状态”这一个根因伸出来的三条**——上行不能流式、双工做不了、成本随轮数涨。
## 八、我最后理解到的
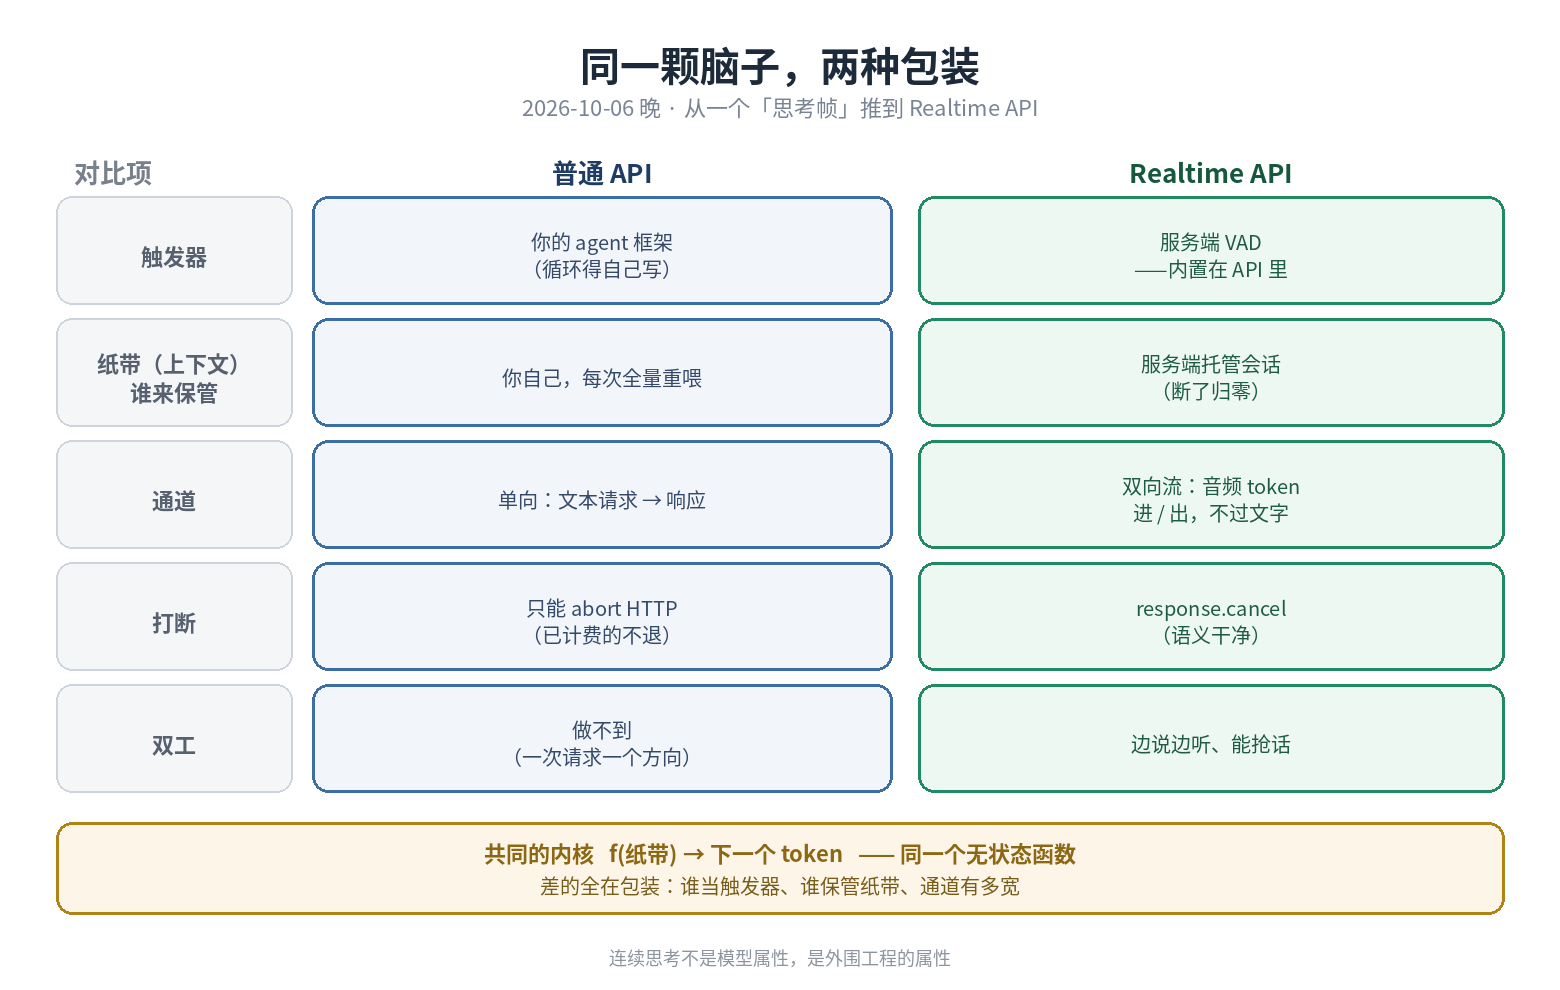
模型那一层,realtime 和普通 API 其实是同一个东西:都是“触发一次、算一次、出一次”。
差的全在包装:**谁是触发器、谁保管纸带、通道有多宽。**
- **普通 API**:你保管纸带,每次全量重喂,触发器在你自己的 agent 框架里;
- **Realtime API**:服务端替你保管会话,触发器是服务端的 VAD。
而所谓“连续思考”,对 LLM 来说从来不是模型属性——**它是外围工程的属性**:把模型的无状态,包成一个有状态的外壳。
## 小结
- 一帧 = 一次前向 = 一个 token;“一次请求”只是人类看得见的边界;
- 连续性在上下文里,不在权重里——模型是 f(纸带) → 下一字;
- 每帧算力固定,所以想得更久只能多写帧(用 token 换深度);
- Realtime API 改的是帧率和带宽,**连续性和主动性它一个都没堵**;
- 触发器、状态托管、通道带宽——这三件事才是 agent 框架真正在补的洞。